知识库答错,八成不是“找不到”,是入库时就没整理好。页眉页脚混进了正文,表格被拆成碎块,三个旧版本并排躺在库里。先做这三件清洗,再谈怎么找。顺序反了就是白忙。
RAG(检索增强生成)的工作方式不复杂。系统先把你的文档切成小段,存进一个能按意思相近来找的库。客户提问时捞出几段,再让模型照着这几段回答。模型看不到没被捞出来的内容,捞到的是碎纸,它就只能编。
所以答案好坏,一半取决于捞得准不准,一半取决于库里到底存了什么。前者是检索,后者是整理。多数团队一上来就调前者,因为它是参数,看起来更像“技术活”。
大多数公司的知识库像一间没编目的图书馆。书全在架子上,但没编号、页码乱、旧版和新版摞在一起。管理员腿再快,也找不准你要的那本。
先自查。下面四种症状,各自指向一个具体原因,不必请人做诊断报告。
| 客户看到的症状 | 先去查什么 |
|---|---|
| 回答里出现去年的数字或旧条款。 | 旧版文档还在库里,没下架。 |
| 答案里冒出“第 3 页 共 12 页”这类字样。 | 页眉页脚没删,混进了正文。 |
| 把 A 型号的参数说成 B 型号的。 | 表格被切成碎块,列名丢了。 |
| 答得含糊,像在编。 | 段落切得太碎,半句话被当成一整条。 |
第一件,去页眉页脚。判断不必靠眼睛:同一行文字出现在六成以上的页面,并且不到 40 字,基本就是页眉或页脚。公司名、密级、“第 3 页 共 12 页”都落在这类里。
六成和 40 字是经验值,不是哪份官方文件的规定。它的作用是让这条规则能交给同事照做,不必每个人凭感觉。删完随机抽二十段读一遍,看不到页码,就算清干净。
文档是写给人看的。页眉写着公司名和第几页,对人有用,对模型却是噪声。一份六十页的制度,页眉重复六十次,模型很容易把这句话当成重点。
第二件,把表格改成能读的文字。从 PDF 转出来的表格多半已经散架:一行只剩一个格子,跨页之后列名也没了。“0.75”单独摆在段落里,模型不知道它是折扣、税率还是重量。
改法是转成一行一句的清单,每行自带列名:“A 型号,保修两年,2026 年 3 月起执行。”转完挑三张跨页的表,只看续页那几行有没有列名。没有,就是没转好。
还有一种更麻烦的文件:扫描件和拍照的 PDF。它们没有文字层,得先做文字识别。识别会把 0 认成 O,把表格线认成笔画。这类文件先抽十页人工对一遍,错得多的整份重扫,别指望在错字上打补丁。
第三件,把旧版下架。同一份制度常有三个版本,扫描件、修订稿、盖章版都在库里。模型不看日期,谁的字面更像就引谁。做法是只留生效中的那一版,旧的移到一个不参与检索的目录。只加一个“作废”标签不够,它照样会被捞出来。
这一件的验收最直接。问一句“现在的报销标准是多少”,回答里不该出现去年的数字。出现了,说明旧文件还在库里,回去找文件,不要调参数。
这三件不花钱,只花时间,也不需要懂代码。去页眉、拆表格、下架旧版,行政和文档岗的同事就能做,只要给一条能照做的规则。
也不必等全部做完才开始用。先清完最常被问的那二十份,库里的回答就会变样,剩下的按批次补。
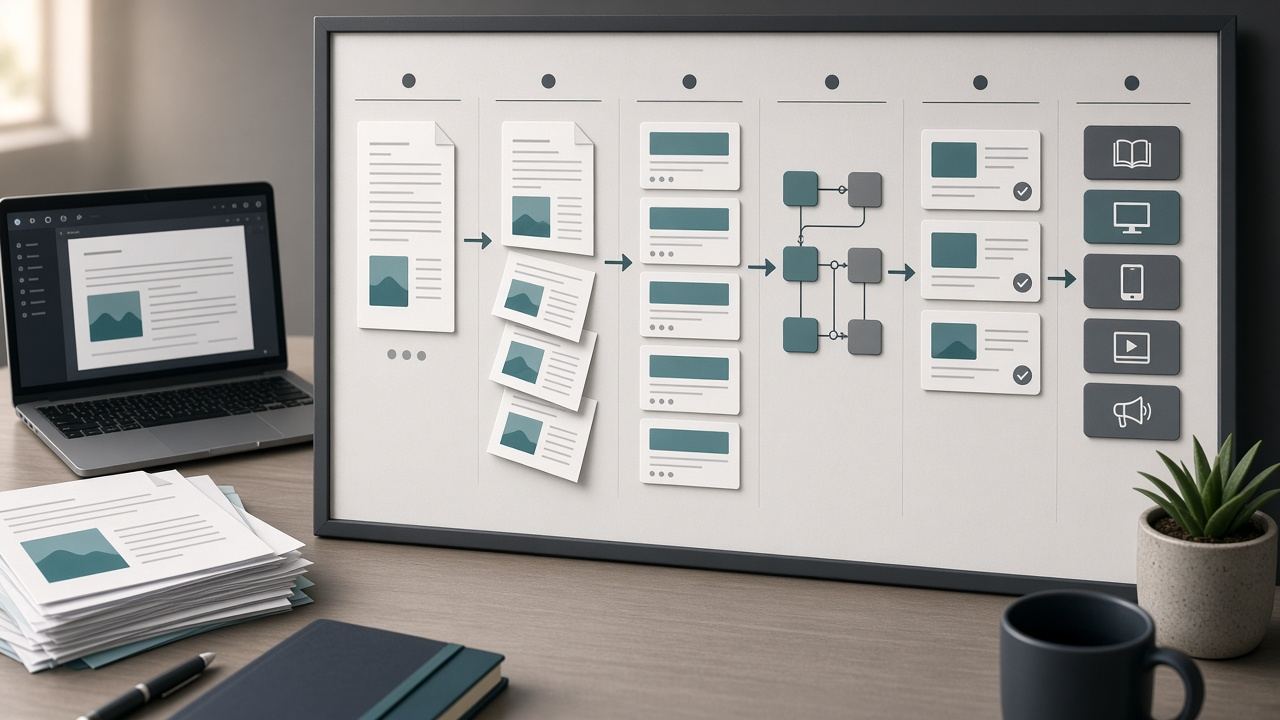
三件做完再谈切分。切分就是把长文档切成一段一段,每段单独入库。
起点值是每段 512 个 token,大约 400 个汉字。token 是模型计数的单位,一个汉字大致算一个多一点,四百字上下对得上。前后各留 25% 的重叠,也就是一百字左右,防止一句话正好被切断。
这两个数出自微软的文档切块指南,是起点建议,不是标准答案(Azure AI Search 切块文档)。你的语料长什么样,只能靠后面那步前后对比来定。
另有一条硬限制:单段最多 8191 个 token,约六千汉字(OpenAI 嵌入模型文档)。超了不会报错,会被悄悄截断,等于丢数据。切完随手查一次最长的那十段,比事后查为什么答错省事得多。
有三处不按字数切。表格不切,一张表一段,列名跟着走。制度条款按编号切,一条一段。报价单、参数表这类也不切。这样平均段长会超过 512,这是对的,别为了凑数字把一张表劈开。
怎么确认改对了:用同一批问题,改前问一遍,改后问一遍。问题别自己编,从客服工单、销售聊天记录、站内搜索框里抄,客户怎么问就怎么写,错别字也保留。二十到五十条就够。
每条要带一个能核对的东西,数字、条款号、型号都行。“大概怎么样”这类问题测的是文风,不算数,先放在外面。
每条记两栏:改前怎么答,改后怎么答。只看三件事。还引不引旧版,数字对不对,有没有页码残留。只要有一条还引旧版,就说明那份文档还在库里,回去查文件,别急着换模型。
不要用“感觉顺畅了”当结论。文风变好和答对是两件事,客户投诉的是后者。也不必追求接近满分,二十条里错两条,通常已经够用。
还有一个常见误区:多捞几段更保险。实测不是这样。相关信息落在材料中间时,模型的得分会明显下降,专门为长输入训练过的模型也一样(Lost in the Middle)。捞得越多,中间越长,越容易被忽略。多给段落不是保险,是稀释。
范围上不必一次做完整个库。先挑被问得最多的二十份文档,一周能看出差别。剩下的分批做,每批做完用同一套问题复问一遍,答错的样本补进问题清单。
等库干净了,再去调一次捞几段、要不要加一层重排。重排就是把捞出来的几段重新排队,把最像答案的放前面。这些参数一天能试好几轮,改坏了也容易退回去。
问题清单建议固定下来,之后每季度复问一次。这份清单比任何仪表盘都准,它记录的是客户真的问过什么。
而清洗没做对,后面每项调优都在一堆碎纸里打分。你会得到一组漂亮的测试成绩,换一批问题就不灵,还查不出原因在哪。